
AI 对工作的影响项目分为两个阶段。在第一阶段,任何加州居民都可以通过一份公开的在线问卷调查分享看法。在第二阶段,我们邀请有兴趣的问卷调查参与者参加现场讨论。
公平地平衡每个群体
我们需要决定邀请谁。我们需要在公平选择的同时组建具有代表性的小组。
因此,我们采用了一种称为抽签(sortition)的方法,类似于法院挑选陪审团的方式。它基于两个同等重要的理念:
- 代表性: 我们根据加州人口估计设定了人口统计目标。这使最终的受邀名单能够反映本州的多样性。标准包括年龄、地理位置和工作领域。
- 随机性: 在这些目标范围内,每位符合条件的人都有同等的入选机会。
这些原则确保我们不只是听取最早回应者的意见。它们帮助我们建立了一份经公平选择的名单,大致反映了加州居民的整体情况。
人口统计
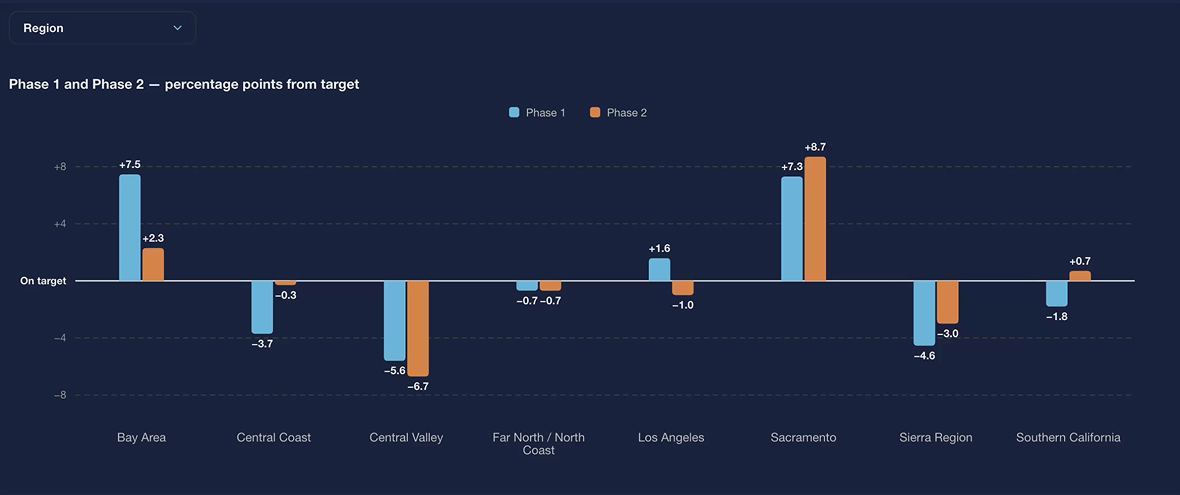
看看我们与人口统计目标的接近程度。点击下拉菜单查看按以下维度的数据:
- 地区
- 种族/族裔
- 性别
- 工作领域
- 年龄
问卷调查与讨论的人口统计对比
抽签让我们在讨论中更接近均衡的人口构成。
目标的来源
- 地区:每个地区都保证有发言权(至少 6 人)。其余名额我们根据美国社区调查(ACS)的估计,按 2026 年加州人口比例分配。
目标的来源
- 种族/族裔:反映 2026 年人口普查/加州财政部的预测。
目标的来源
- 性别:反映 2026 年人口普查/加州财政部的预测。
目标的来源
- 工作领域:基于加州就业发展部的2026 年 4 月行业就业与劳动力(CES)统计数据和地区选择表。提交给州长办公室的备忘录特别将物流、医疗保健、法律和金融服务、创意产业、公共部门和学术界列为优先领域。我们在这些类别中体现了这一点。
目标的来源
- 年龄:反映 2026 年人口普查/加州财政部的预测。
关于抽签的更多信息
- 我们的抽签代码
- Sortition Foundation,为什么使用抽签算法?(英文)
政策想法排名
在讨论中,参与者提出政策想法,然后以小组形式进行投票。
我们汇集了在讨论中至少获得一票的所有想法。然后,我们将相似的想法归为一组,并为每组撰写摘要。这些就成为 26 个政策想法。每个政策想法涵盖 1 到 12 条具体的政策建议。
为了对政策想法进行排名,我们根据 2 个因素对每个想法进行评估:
- 频率: 某个政策想法在 14 场讨论中出现的次数。范围为 1 到 8。
- 支持度: 某个政策想法是否进入了某场讨论的得票前列。要进入前列,它必须获得足够的票数,位列前三分之一。范围为 0 到 5。
我们按频率对政策想法列表进行排序。然后大致分成两半,将上半部分标记为“高频”。如果某个想法出现在 5 场或更多讨论中,则属于“高频”。
然后,我们按支持度对政策想法进行排序。如果某个想法的相关想法在所有场次中都位列前 3 个主题,我们就将其标记为“热门想法”。
想法的排列顺序有其意义,但并非绝对。对于每个因素,我们计算了该想法相对于所有其他想法的排名。然后将这些排名相加,为每个想法打分。我们将得分最高的想法排在最前面。当政策想法得分相同时,我们按字母顺序排列。
下载所有政策想法
您可以下载并阅读人们在讨论中提出的所有政策。它们以 CSV 文件的形式提供。
我们如何使用 AI
我们的工作人员使用 AI 来协助审阅和分析这些讨论。
AI 的使用示例包括:
- 将讨论音频转换为文字记录,
- 生成讨论和问卷调查回应的总体摘要,以及
- 按所涉及的想法为对话片段添加标签。
AI 没有参与选择我们邀请谁参加讨论。我们通过抽签选择受邀者。我们确保受邀群体反映加州的人口构成。我们还使用 AI 来评估回应者对 AI 的看法。这为我们带来了多元的观点。
我们保护参与者与我们分享的内容。所有涉及 AI 的工作都在本州的安全数据环境中进行。我们从未与 AI 供应商共享文字记录或问卷调查回应。没有任何内容被用于训练 AI 模型。
AI 从未取代人的判断,也从未撰写或编辑参与者的话。本报告中的每一条引言都是参与者说过的话。我们对照文字记录进行了核实,并由工作人员审阅。
本报告中重点介绍的政策想法和主题由我们的工作人员自行确定。他们在没有 AI 协助的情况下审阅了文字记录和问卷调查回应。当 AI 协助分析时,我们要求它提供确切的引文。工作人员在采信这些说法之前对其进行了核实。
在测试中,我们将 AI 的摘要与人工记录员的笔记进行了比较。我们发现二者涵盖的内容相同,且 AI 没有编造内容。

