
AI 對工作的影響計畫分為兩個階段。在第一階段,任何加州居民都可以透過一份公開的線上問卷調查分享看法。在第二階段,我們邀請有興趣的問卷調查參與者參加現場討論。
公平地平衡每個群體
我們需要決定邀請誰。我們需要在公平選擇的同時組成具有代表性的小組。
因此,我們採用了一種稱為抽籤(sortition)的方法,類似於法院挑選陪審團的方式。它基於兩個同等重要的理念:
- 代表性: 我們根據加州人口估計設定了人口統計目標。這使最終的受邀名單能夠反映本州的多樣性。標準包括年齡、地理位置和工作領域。
- 隨機性: 在這些目標範圍內,每位符合條件的人都有同等的入選機會。
這些原則確保我們不只是聽取最早回應者的意見。它們幫助我們建立了一份經公平選擇的名單,大致反映了加州居民的整體情況。
人口統計
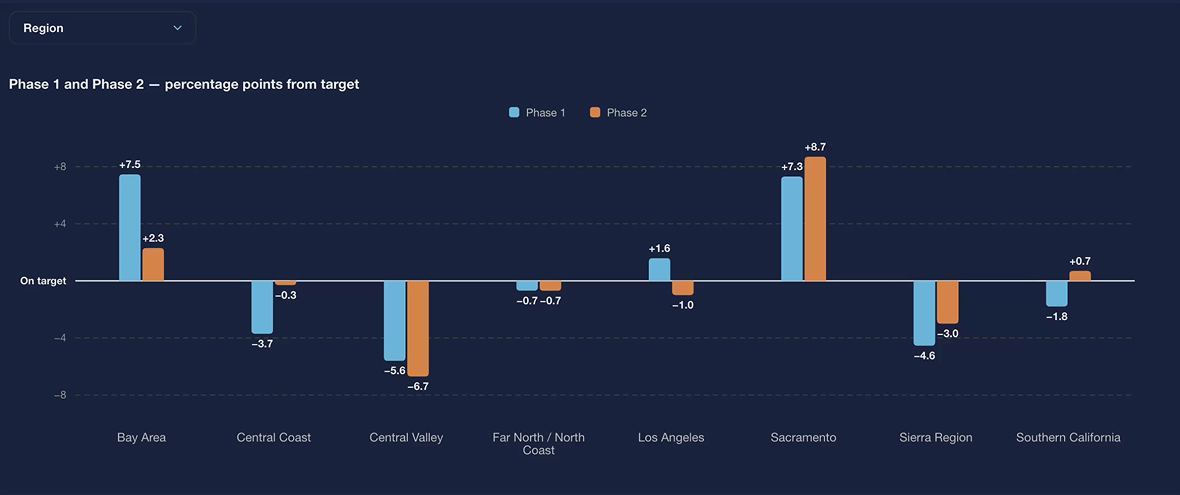
看看我們與人口統計目標的接近程度。點選下拉式選單查看按以下維度的數據:
- 地區
- 種族/族裔
- 性別
- 工作領域
- 年齡
問卷調查與討論的人口統計對比
抽籤讓我們在討論中更接近均衡的人口組成。
目標的來源
- 地區:每個地區都保證有發言權(至少 6 人)。其餘名額我們根據美國社區調查(ACS)的估計,按 2026 年加州人口比例分配。
目標的來源
- 種族/族裔:反映 2026 年人口普查/加州財政部的預測。
目標的來源
- 性別:反映 2026 年人口普查/加州財政部的預測。
目標的來源
- 工作領域:基於加州就業發展部的2026 年 4 月產業就業與勞動力(CES)統計資料和地區選擇表。提交給州長辦公室的備忘錄特別將物流、醫療保健、法律和金融服務、創意產業、公共部門和學術界列為優先領域。我們在這些類別中體現了這一點。
目標的來源
- 年齡:反映 2026 年人口普查/加州財政部的預測。
關於抽籤的更多資訊
- 我們的抽籤程式碼
- Sortition Foundation,為什麼使用抽籤演算法?(英文)
政策想法排名
在討論中,參與者提出政策想法,然後以小組形式進行投票。
我們彙集了在討論中至少獲得一票的所有想法。然後,我們將相似的想法歸為一組,並為每組撰寫摘要。這些就成為 26 個政策想法。每個政策想法涵蓋 1 到 12 條具體的政策建議。
為了對政策想法進行排名,我們根據 2 個因素對每個想法進行評估:
- 頻率: 某個政策想法在 14 場討論中出現的次數。範圍為 1 到 8。
- 支持度: 某個政策想法是否進入了某場討論的得票前列。要進入前列,它必須獲得足夠的票數,位列前三分之一。範圍為 0 到 5。
我們按頻率對政策想法清單進行排序。然後大致分成兩半,將上半部分標記為「高頻」。如果某個想法出現在 5 場或更多討論中,則屬於「高頻」。
然後,我們按支持度對政策想法進行排序。如果某個想法的相關想法在所有場次中都位列前 3 個主題,我們就將其標記為「熱門想法」。
想法的排列順序有其意義,但並非絕對。對於每個因素,我們計算了該想法相對於所有其他想法的排名。然後將這些排名相加,為每個想法評分。我們將得分最高的想法排在最前面。當政策想法得分相同時,我們按字母順序排列。
下載所有政策想法
您可以下載並閱讀人們在討論中提出的所有政策。它們以 CSV 檔案的形式提供。
我們如何使用 AI
我們的工作人員使用 AI 來協助審閱和分析這些討論。
AI 的使用範例包括:
- 將討論音訊轉換為文字記錄,
- 產生討論和問卷調查回應的整體摘要,以及
- 按所涉及的想法為對話片段加上標籤。
AI 沒有參與選擇我們邀請誰參加討論。我們透過抽籤選擇受邀者。我們確保受邀群體反映加州的人口組成。我們還使用 AI 來評估回應者對 AI 的看法。這為我們帶來了多元的觀點。
我們保護參與者與我們分享的內容。所有涉及 AI 的工作都在本州的安全資料環境中進行。我們從未與 AI 供應商共享文字記錄或問卷調查回應。沒有任何內容被用於訓練 AI 模型。
AI 從未取代人的判斷,也從未撰寫或編輯參與者的話。本報告中的每一條引言都是參與者說過的話。我們對照文字記錄進行了核實,並由工作人員審閱。
本報告中重點介紹的政策想法和主題由我們的工作人員自行確定。他們在沒有 AI 協助的情況下審閱了文字記錄和問卷調查回應。當 AI 協助分析時,我們要求它提供確切的引文。工作人員在採信這些說法之前對其進行了核實。
在測試中,我們將 AI 的摘要與人工記錄員的筆記進行了比較。我們發現二者涵蓋的內容相同,且 AI 沒有編造內容。

